用語小辭典(Glossary)
本路線圖會大量出現「LLM」、「RAG」、「MCP」、「agent」這類詞。讀到不懂的詞先在這裡查 30 秒,再回去讀 stage 內容。
每個詞只給最小可用的解釋(30-80 字 + 在哪一個 stage 講細的)——不是維基百科。
🌐 統一詞彙對照表(中英對照、跨 stage 一致)
本表是專案內強制統一的命名約定——所有 stage 用同一個中文理解名。如果你在 stage 內看到不一致,請報 issue。
| 英文術語 | 中文理解名 | 主要 stage |
|---|---|---|
| Prompt Engineering | Prompt 設計 | Stage 2 |
| Context Engineering | 上下文管理 | Stage 6 |
| Harness Engineering | Agent 執行系統設計 | Stage 7 |
| Tool Use | 工具使用 | Stage 3 |
| Function Calling | 函式 / 工具呼叫 | Stage 3 |
| Structured Output | 結構化輸出 | Stage 3 |
| Agent Loop | Agent 執行迴圈 | Stage 3 |
| Framework | 框架 | Stage 4 |
| Orchestration | 協調與編排 | Stage 4 / 7 |
| Handoff | 任務交接 | Stage 7 |
| Supervisor / Worker | 協調者 / 執行者 | Stage 7 |
| Runtime | 執行層 | Stage 7 |
| Scaffolding | 支撐架構 | Stage 7 |
| Observability | 觀測與紀錄 | Stage 7 |
| Telemetry | 運行紀錄 | Stage 7 |
| Eval | 效果評估 | Stage 7 |
| Evaluation Harness | 評估框架 | Stage 7 |
| Production | 可穩定使用 / 上線化 | Stage 7 |
| Production-grade | 可長期穩定使用的 | Stage 7 |
| Deployment | 部署 | Stage 7 |
| Cost Tracking | 成本追蹤 | Stage 7 |
| Latency | 延遲 / 等待時間 | Stage 7 |
| Vector DB | 向量資料庫 | Stage 6 |
| Retrieval | 檢索 | Stage 6 |
| Reranking | 重排序 | Stage 6 |
| Long Context | 長上下文 | Stage 6 |
| Fine-tuning | 模型微調 | Stage 6 |
| Agent Interfaces | Agent 操作介面 | Stage 8 |
| Code Sandbox | 隔離程式執行環境 | Stage 8 |
| Cold Start | 啟動延遲 | Stage 8 |
| Reward Hacking | 鑽評分漏洞 | Stage 7 / 8 |
→ 詳細定義請看下面各區塊。
1. 基本概念
LLM(Large Language Model,大語言模型)
GPT、Claude、Gemini 這類「給文字、回文字」的模型。本身是純函式:input prompt → output text。它不會自己上網、不會記住上次對話——這些都要外接系統來做。
📍 詳細:Stage 1
Token
LLM 看到的不是「字」,是 token(次字單位)。中文 1 個字 ≈ 1.5-2 token,英文 1 個 word ≈ 1.3 token。LLM 計費跟 context window 都以 token 計。「100 萬 token context」≈ 75 萬中文字。
📍 詳細:Stage 1
Context Window(上下文視窗)
LLM 一次能「看」多少 token。2026 frontier:Claude Sonnet 4.6 / Opus 4.7 1M、GPT-5.5 ~400k、Gemini 3.1 Pro 2M。不是越大越好——超過某個長度後 LLM 會「在中間遺漏」(Lost in the Middle)。
Prompt(提示詞)
你給 LLM 的輸入文字。Prompt engineering 就是設計這段輸入讓 LLM 給好答案。System prompt(角色設定)+ user prompt(這次的問題)是基本結構。
📍 詳細:Stage 2
Few-shot / Zero-shot
- Zero-shot:直接問問題不給範例。
- Few-shot:給 2-5 個 input → output 的範例後再問。Few-shot 通常顯著提升準確度,特別是格式要求嚴的任務。
Chain-of-Thought(CoT,思維鏈)
要 LLM「先想再答」——讓它輸出推理過程再給結論。兩種形式:
- Few-shot CoT(原始 paper、Wei et al. 2022):在 prompt 裡放幾個含推理步驟的範例、LLM 模仿著想
- Zero-shot CoT(Kojima et al. 2022):prompt 結尾加「Let's think step by step」就觸發 reasoning trace
準確度通常會提升、代價是 token 數變多。Few-shot 通常比 zero-shot 準。
2. Agent / 工具使用
Agent(代理人)
以 LLM 為核心、能在迴圈中感知狀態 → 做決策 → 採取行動 → 觀察結果、重複到完成目標的系統。核心三要素:
- LLM(推理 / 規劃 / decide)
- Actions(做事的手段——不限於 function call。可以是寫程式碼執行(CodeAct)、操作瀏覽器(computer use)、查 KB(RAG retrieval)、call MCP server、純規劃分解任務等)
- Loop(心跳——agent 跟純 LLM Q&A 的根本差別)
差別在於:純 LLM = Q&A、agent = 三要素 + 持續迴圈直到目標達成或耗盡 budget。ReAct 是其中一種 agent pattern、不是 agent 的定義——CodeAct、computer-use、planning agent 都是 agent。
📍 詳細:Stage 3
Tool Use / Function Calling
讓 LLM 呼叫你定義好的 function(查 DB、算數學、開瀏覽器…)。LLM 回的不是文字而是 {"function": "search", "args": {...}}、你的程式去執行、把結果再丟回 LLM。
兩個詞概念相同、API schema 不一樣:
- Anthropic「Tool Use」:schema 用
input_schema(JSON Schema 直接放) - OpenAI / Ollama「Function Calling」:包一層
{"type": "function", "function": {...}}外層 - LLM 內部接收的 token 表達不同、寫 SDK 跨家時要記得對應好
📍 詳細:Stage 3 📍 schema 怎麼寫好:Function Schema 設計 cheatsheet
ReAct(Reasoning + Acting)
最經典的 agent pattern:Thought(想)→ Action(叫工具)→ Observation(看結果)→ Thought ... 一直 loop 到答得出來。多數 agent framework 內部都實作這個。
📍 詳細:Stage 3
Structured Output(結構化輸出)
要 LLM 輸出 JSON / 其他固定 schema,而不是自由文字。各家 LLM API 都有 response_format 或類似旗標支援。Agent 框架幾乎都靠這個跟 LLM 溝通。
Agent Loop
「LLM → tool → 結果 → LLM」這個重複的循環。Loop 結束條件可能是:LLM 說「I'm done」、跑超過 N 步、超出 budget。
Self-Refine(基本版反思 / 無記憶)
agent 自我評估上一回合輸出、改下一回合的 pattern——「Actor 出答案 → Critic 找問題 → Actor 看 feedback 再答」的 single-session loop。不需要持久記憶層,純粹是 reasoning loop 機制、是 ReAct 的 sibling pattern。production agent(Cursor / Cline / Claude Code)每天在跑這個變種。
代表 paper:Self-Refine (Madaan 2023)。完整版 Reflexion(含 episodic memory)見 3 Memory / Retrieval / RAG(不同層的東西)。
📍 詳細 + 路由:Stage 3 反思
3. Memory / Retrieval / RAG
Memory(記憶)— 兩種正交分類軸
「memory」常被混為一談、其實有 2 種正交分類軸:
- 時效軸:short-term(當前對話) vs long-term(跨 session 持久)
- 內容軸(CoALA framework):Working(暫存)/ Episodic(過去經歷)/ Semantic(事實知識)/ Procedural(怎麼做)
→ 兩軸不互斥:long-term memory 裡可以同時有 episodic(user 上次說了什麼)+ semantic(公司知識庫事實)+ procedural(用過的 tool sequence)。
📍 詳細:Stage 6 Memory 是什麼 + 怎麼設計 + Stage 6 CoALA framework
RAG(Retrieval-Augmented Generation)
兩階段架構模式:
- Ingest(一次性 / 定期):document → chunk → embed → 存進 vector store(建可檢索的 KB)
- Query(每次 user 問問題):question embed → semantic search(或 hybrid + BM25)→ top-K chunks → 塞進 prompt → LLM 答
解決 LLM 不知道你私有 / 變動 / 過期資料。Retrieval 不限於 dense embedding——production 標配是 hybrid(dense + BM25)+ reranker。
📍 詳細:Stage 6 📍 paper:Lewis et al. 2020
Reflexion(完整版反思 / 帶 episodic memory)
跟 Self-Refine(2 Agent)不同:Reflexion 需要持久 episodic memory store——agent 跑完 trial 後寫一段 reflection summary 進 memory、下一次 trial 開始時 retrieve 進 prompt。跨 trial 累積教訓是 Reflexion 的本質(不是 single-session loop)。
放在 3 而非 2 Agent 因為它本質是 memory pattern——episodic memory store 是核心、不是 optional。
代表 paper:Reflexion (Shinn 2023)。
📍 詳細:Stage 6 進階:帶持久記憶的 Reflexion 完整版
Embedding(嵌入)
把文字 / 圖片轉成 N 維向量、讓「意思接近的東西距離近」。本路線圖預設指 dense embedding(稠密向量、sentence-transformers / OpenAI ada-002 等產生);另有 sparse embedding(BM25 / SPLADE 等、用字面 token 比對)——production RAG 兩者並用做 hybrid search。
📍 詳細:Stage 6
Vector DB(向量資料庫)
存 + 高效查 embedding 的儲存層。主要查詢類型 = approximate nearest-neighbor (ANN)——所以 Vector DB 存在的意義就是「ANN 比直接 cosine 全掃快幾百倍」。代表:Pinecone / Chroma / Qdrant / Weaviate / pgvector。
📍 詳細:Stage 6
Semantic Search(語意搜尋)
用 embedding 比較「意思相似」而不是「字串完全相同」。「電動車怎麼充電」可以撈到「EV charging tutorial」。傳統關鍵字搜尋(BM25 等)做不到這個。
Chunking(切塊)
把長文件切成適合 embedding 的小段(通常 200-1000 token)。切法直接影響 RAG 品質——切太碎丟脈絡、切太長相關度模糊。常見策略:固定大小、按段落、按結構(heading)。
Hybrid Search(混合搜尋)
語意搜尋 + 關鍵字搜尋一起用,再 merge 排序。多半比單一方法準。production-grade RAG 標配。
Reranking(重新排序)
第一輪 retrieval 撈 top-50,再用更貴但更準的模型(cross-encoder)重排成 top-5 給 LLM。Cohere Rerank、bge-reranker 等。
Contextual Retrieval
Anthropic 2024 提的方法——chunk 加上「整份文件的脈絡摘要」一起 embed,避免「這 chunk 拿出來看不知道是哪份文件講的」問題。
📍 詳細:Stage 6
Fine-tuning(模型微調)
拿你自己的資料再訓練模型、把知識或行為「燒進」權重裡(跟 RAG 不同——RAG 是 inference 時才把資料塞進 context、不改權重)。適合讓模型穩定學會某種格式 / 風格 / 領域用語;不適合拿來塞「最新事實」(那是 RAG 的活,fine-tune 進去的事實會過期又難更新)。多數 agent 場景先試 prompt + RAG,真的不夠才考慮 fine-tune。
📍 詳細:Stage 6
4. Multi-Agent
Multi-Agent(多 agent)
多個 agent 互相協作完成一個任務。常見 pattern:
- Supervisor + Worker:一個 agent 規劃 / 分派、其他執行
- Swarm(群集):平等的 agent 群,沒有固定 supervisor
- Debate(辯論):多個 agent 各持立場、最後 consensus
📍 詳細:Stage 7
Handoff
一個 agent 把任務交給另一個 agent。比直接 function call 多了「context 怎麼傳」、「失敗誰處理」的問題。
A2A(Agent-to-Agent)Protocol
Google 推的 agent 之間溝通協定,類似 MCP 但用於 agent ↔ agent,不是 agent ↔ tool。
5. Claude Code 生態
MCP(Model Context Protocol)
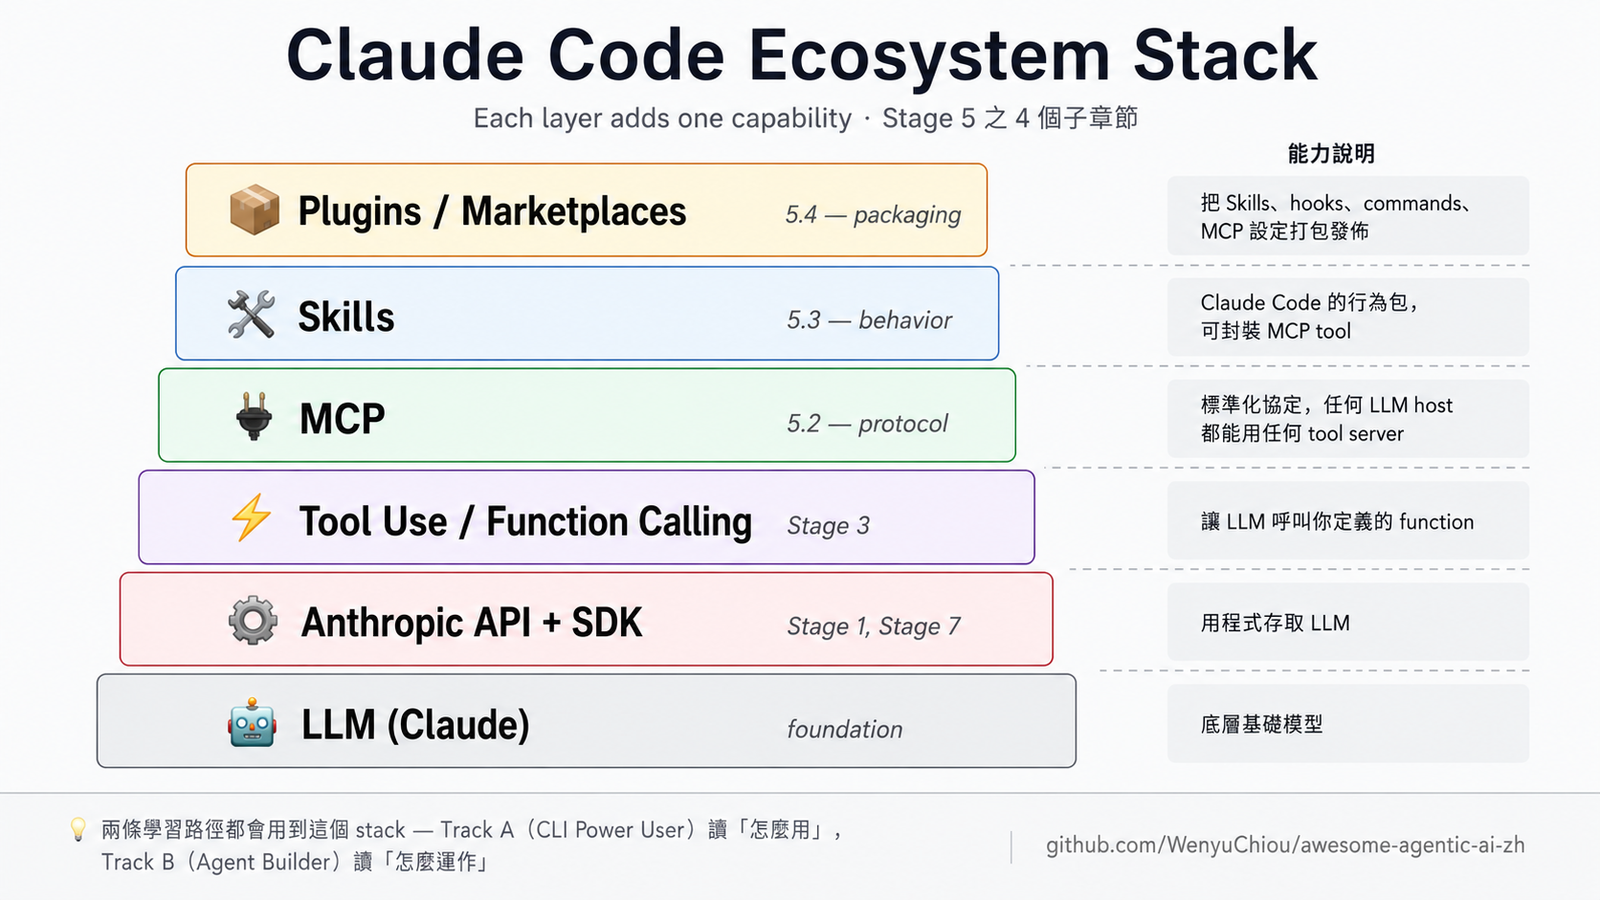
Anthropic 2024 推的開放協定、讓任何 LLM host(Claude Code、Cursor、自寫 agent)用同一套介面接外部 tool server。把它想成「LLM 的 USB 接口」。
技術上標準化 3 種 primitives:
- Tools:LLM 可呼叫的 function(read DB / search web / send email…)
- Resources:LLM 可讀取的資料(檔案內容、API response、DB rows…)
- Prompts:可複用的 prompt 模板(給 user 在 host 內
/觸發)
架構:server / client 模式——tool server 跑在本機或遠端、LLM host 當 client 連接。Server 用 stdio / SSE / HTTP 三種 transport 之一暴露 primitives。
📍 詳細:Stage 5.2
Skills / SKILL.md
Claude Code 的「行為包」。一個 Skill = 一個資料夾含 SKILL.md(描述「在什麼情境要做什麼、可呼叫哪些 tool」)+ 可選的 reference files / scripts。
觸發機制(很多人不知道、很關鍵):Claude Code 每次處理你訊息前、會掃所有可用 skill 的 frontmatter description 欄位——匹配當下情境就把對應 SKILL.md 自動載入。所以 description 寫得好不好直接決定 skill 會不會被觸發。寫法:以「Use when ...」開頭最有效。
📍 詳細:Stage 5.3
Plugin / Marketplace
把多個 Skills + slash commands + hooks + MCP 設定打包成一個發布單位。Marketplace 就是 plugin 的目錄,社群可以 claude plugin install 安裝別人寫好的。
📍 詳細:Stage 5.4
Slash Command
Claude Code 內以 / 開頭的指令(/help、/compact、/plan 等)。可以自訂——把一段 prompt 存到 .claude/commands/<name>.md 就變成 /name。
CLAUDE.md
放在 project root 的 markdown 檔,Claude Code 每次啟動都會讀。寫 project 級的規則 / 規範 / context(用什麼語言、coding style、別動哪些檔等)。
Hooks
在 Claude Code 特定事件前後執行的 script。官方支援 7 種事件類型:
| Hook | 觸發時機 | 典型用途 |
|---|---|---|
PreToolUse | 工具呼叫前 | 攔截危險操作(rm -rf、destructive op)、改參數 |
PostToolUse | 工具呼叫後 | log 記錄、auto-format 寫完的檔 |
UserPromptSubmit | user 訊息送出時 | 加 context(git status / 當前時間) |
Notification | Claude Code 通知時 | 桌面 toast / Slack ping |
Stop | session 結束時 | 自動 commit / 清理 |
PreCompact | 自動 compact 前 | 把重要決定 promote 到 memory |
PostCompact | compact 後 | 確認哪些 context 被壓縮 |
寫法:.claude/settings.json 加 "hooks" 區塊、指 script 路徑。
Subagent(子 agent)
主 Claude Code session 之外,spawn 出來跑特定任務的 agent。有自己的 context window。例如「給我一個 code-reviewer subagent 看看 diff」。
寫法:在 .claude/agents/<name>.md 放 frontmatter + system prompt + tool whitelist。主 session 用 Task tool invoke(自動 parallel / sequential)。跟 framework-based multi-agent 對照:subagent 不需要裝 LangGraph / CrewAI 等 framework、直接寫 markdown 即可;但綁 Claude Code runtime。完整教學見 Stage 5.5;15 個複製貼上即用的 dispatch recipe → subagent-cookbook.md;自己寫 / 組合 / debug 進階主題 → subagent-advanced.md。
6. Production / Eval / Cost
Eval(評估框架)
針對 agent 跑一組 test case,量化它的準確度 / latency / cost。production agent 沒有 eval 等於沒有測試。常見工具:promptfoo、LangSmith、langfuse evals。
📍 詳細:Stage 7
Observability
把 agent 內部跑的每一步(哪個 LLM call、哪個 tool、什麼結果)都記下來。出 bug 時能 replay。常見:langfuse、Helicone、weave。
📍 詳細:Stage 7
Prompt Caching
LLM 把 prompt 前綴 cache 起來,下次同前綴只算 cache hit 的便宜價(Anthropic 90% off、OpenAI 50% off)。Long context + 重複 query 的場景可以省很多錢。
Streaming(串流輸出)
LLM 邊生邊回(一個 token 一個 token),不是等全部生完才丟整段回來。讀者體驗較好(像在打字);技術上用 SSE 或 chunked transfer。production 互動式應用幾乎都開。代價:客戶端要能 handle partial response、ReAct 內 tool call 解析要等到 stream 結束。
Batch API(批次 API)
把大量 LLM 請求打包送(不要求即時),24 小時內回。Anthropic / OpenAI 通常打 5 折。適合非互動場景:批次摘要、批次分類、eval 跑大量 test case、ETL pipeline。互動式 chat 不能用——延遲對使用者體驗來說太久。
Token Cost / Inference Cost
每次 LLM 呼叫的成本 = input tokens × input price + output tokens × output price。Agent 跑 ReAct loop 的成本可以累積很快——大 codebase grep 一次可能花 10 萬 token。
Guardrails
防 LLM 做壞事的規則層——擋掉 prompt injection、PII 外流、有害輸出等。NeMo Guardrails、Guardrails AI 等。
7. 用詞 / Buzzword
CLI Agent
跑在終端機的 agent(Claude Code、Codex、Aider、Gemini CLI 等)。對比於跑在 IDE 內(Cursor、Continue)或 web 上(ChatGPT、Claude.ai)。
📍 詳細:Track A A1、resources/cli-agents-guide.md
BYO API Key(Bring Your Own)
工具支援你自己提供 API key 而不是綁訂閱。Aider / OpenCode / goose 等 CLI 都是 BYO;Claude Code / Codex 預設是訂閱制。
Local LLM / On-Device
模型跑在你自己機器上(Ollama、llama.cpp、MLX、LocalAI 等),資料不外傳。隱私 OK 但能力比 frontier 模型有差。
📍 詳細:Stage 1
Quantization(量化)
把模型權重從 fp16 壓到 int8 / int4,省記憶體跟速度,代價是準確度小幅降低。Local LLM 用戶常碰到(Q4_K_M、Q8_0 等)。
Hallucination(幻覺)
LLM 「自信地說錯」——把不存在的 API 編出來、把錯的數字當成事實寫。所有 production agent 都要防這個(用 RAG / structured output / eval / guardrails)。
Frontier Model
當下最頂的模型(2026-05:GPT-5.5、Claude Opus 4.7、Gemini 3.1 Pro、DeepSeek-V4-Pro 等)。一般智慧任務用 frontier;簡單分類 / 翻譯用便宜的小模型省錢。
Context Engineering
工程「每次 LLM call 時、context window 裡裝什麼資訊」的學科——動態把 RAG retrieve 結果、memory、tool definitions、對話 history 組裝成 LLM 看得到的 context。Karpathy 2025:「填進 window 的資訊剛好對下一步有用的精細藝術」。重點是 what goes in the window、不是「跨幾次 call」。Prompt engineering 的下一層——前者工程字串、後者工程資訊。
📍 詳細:Stage 2 結尾 / Stage 6 / Stage 7 📍 延伸:Meirtz/Awesome-Context-Engineering
Harness Engineering
工程「模型外圍的執行與控制層」——所有不是 model weights、也不是 prompt string 本身的工程元件:agent loop / tool registry / context manager / permissions / safety layer / memory layer / eval / observability / retry / circuit breaker 等。Simon Willison 2025:「coding agent = LLM + harness」、Addy Osmani:「harness = 所有不是 model 本身的程式碼」。OpenAI 2026-02 也使用 "Harness Engineering" 這個說法。Claude Code、Cursor、OpenCode 等 CLI agent 都是 harness。framework 把 LLM 包成 agent、harness 把 agent 包成可上線使用的產品。
對比:
- Framework(Stage 4)規範 API:你呼叫的介面長什麼樣
- Harness(本詞)規範 runtime:怎麼跑、怎麼 recovery、怎麼觀測
📍 學科級概念(8 個核心元件 / prompt→context→harness 三層工程分工 / framework vs harness):Stage 7 Harness Engineering 📍 Reference implementation case study(讀 Claude Code source):Stage 5 5.6 📍 延伸:anthropics/claude-agent-sdk-python、ai-boost/awesome-harness-engineering、ZhangHanDong/harness-engineering-from-cc-to-ai-coding
8. Agent Interfaces
Computer Use(螢幕級 agent)
Agent 透過 screenshot → vision → 算座標 → 模擬鍵鼠 操作真實桌面 app——不靠 API、直接像人類用螢幕。代表:Anthropic Claude Computer Use(Opus 4.7 / Sonnet 4.6)/ OpenAI Codex desktop / Google Gemini in Chrome。2024-10 Anthropic 公開 beta 開啟、2026 OSWorld 達 76.26% superhuman。
📍 完整解說 + 4 強對比:Stage 8 Computer Use
Browser Use(web 級 agent)
Agent 操作網頁、主要用 DOM-aware navigation(直接 query CSS selector)+ 必要時 vision fallback。代表閉源:Atlas / Comet / Dia / Gemini in Chrome。代表 OSS:browser-use(★ 86k+)。
📍 完整解說 + 5 強對比 + OSS 框架:Stage 8 Browser Use
Sandbox(程式碼隔離環境)
讓 agent 寫的 code 在隔離環境跑、不在 host 機器——避免 agent rm -rf / / 連 internet 泄資料 / 偷 credentials 等災難。代表:E2B(Firecracker microVM)/ Daytona(Container)/ Modal(GPU sandbox)/ Vercel / Cloudflare。OpenAI Agents SDK 2026-04 內建支援這些 provider。
📍 完整 9-row 術語小辭典(含 microVM / Container 差異)+ 7 強對比:Stage 8 Code Sandbox
microVM(micro Virtual Machine)
VM 的精簡版、極小 footprint、啟動 < 100ms 但仍獨立 kernel——介於 Docker container(快 + 弱隔離)跟 full VM(慢 + 強隔離)之間。Agent sandbox 多半選 microVM。代表實作:Firecracker(AWS、E2B 用)。
📍 完整對比:Stage 8 術語小辭典
Firecracker
AWS 開源的 microVM、Rust 寫、AWS Lambda 底層 + E2B sandbox 用它做 isolation。強隔離 + 快啟動兼顧。
gVisor
Google 寫的「用戶空間 kernel」、攔截 syscall 自己模擬、不用 hypervisor——介於 container 跟 VM。
找不到的詞?
- 看 Stage 5.2 — MCP / 5.3 — Skills / 5.4 — Plugins 的內文
- 看 Stage 1 / Stage 6 / Stage 7 / Stage 8 的延伸閱讀清單
- 找不到的詞 → 開 issue 或直接 PR 加進這份小辭典